业务链路排障实践
业务链路首页用于日常判断哪些业务需要关注;发现异常后,可以沿同一业务路径定位节点、关联观测数据并验证恢复。本指南覆盖从日常监控到异常闭环的完整过程。
前提条件
- 目标业务链路已建立并持续接收数据。
- 关键节点已配置指标;需要告警状态时,已关联告警规则。
- 你具有相关指标、告警、日志和调用链数据的查看权限。
1. 发现并筛选异常
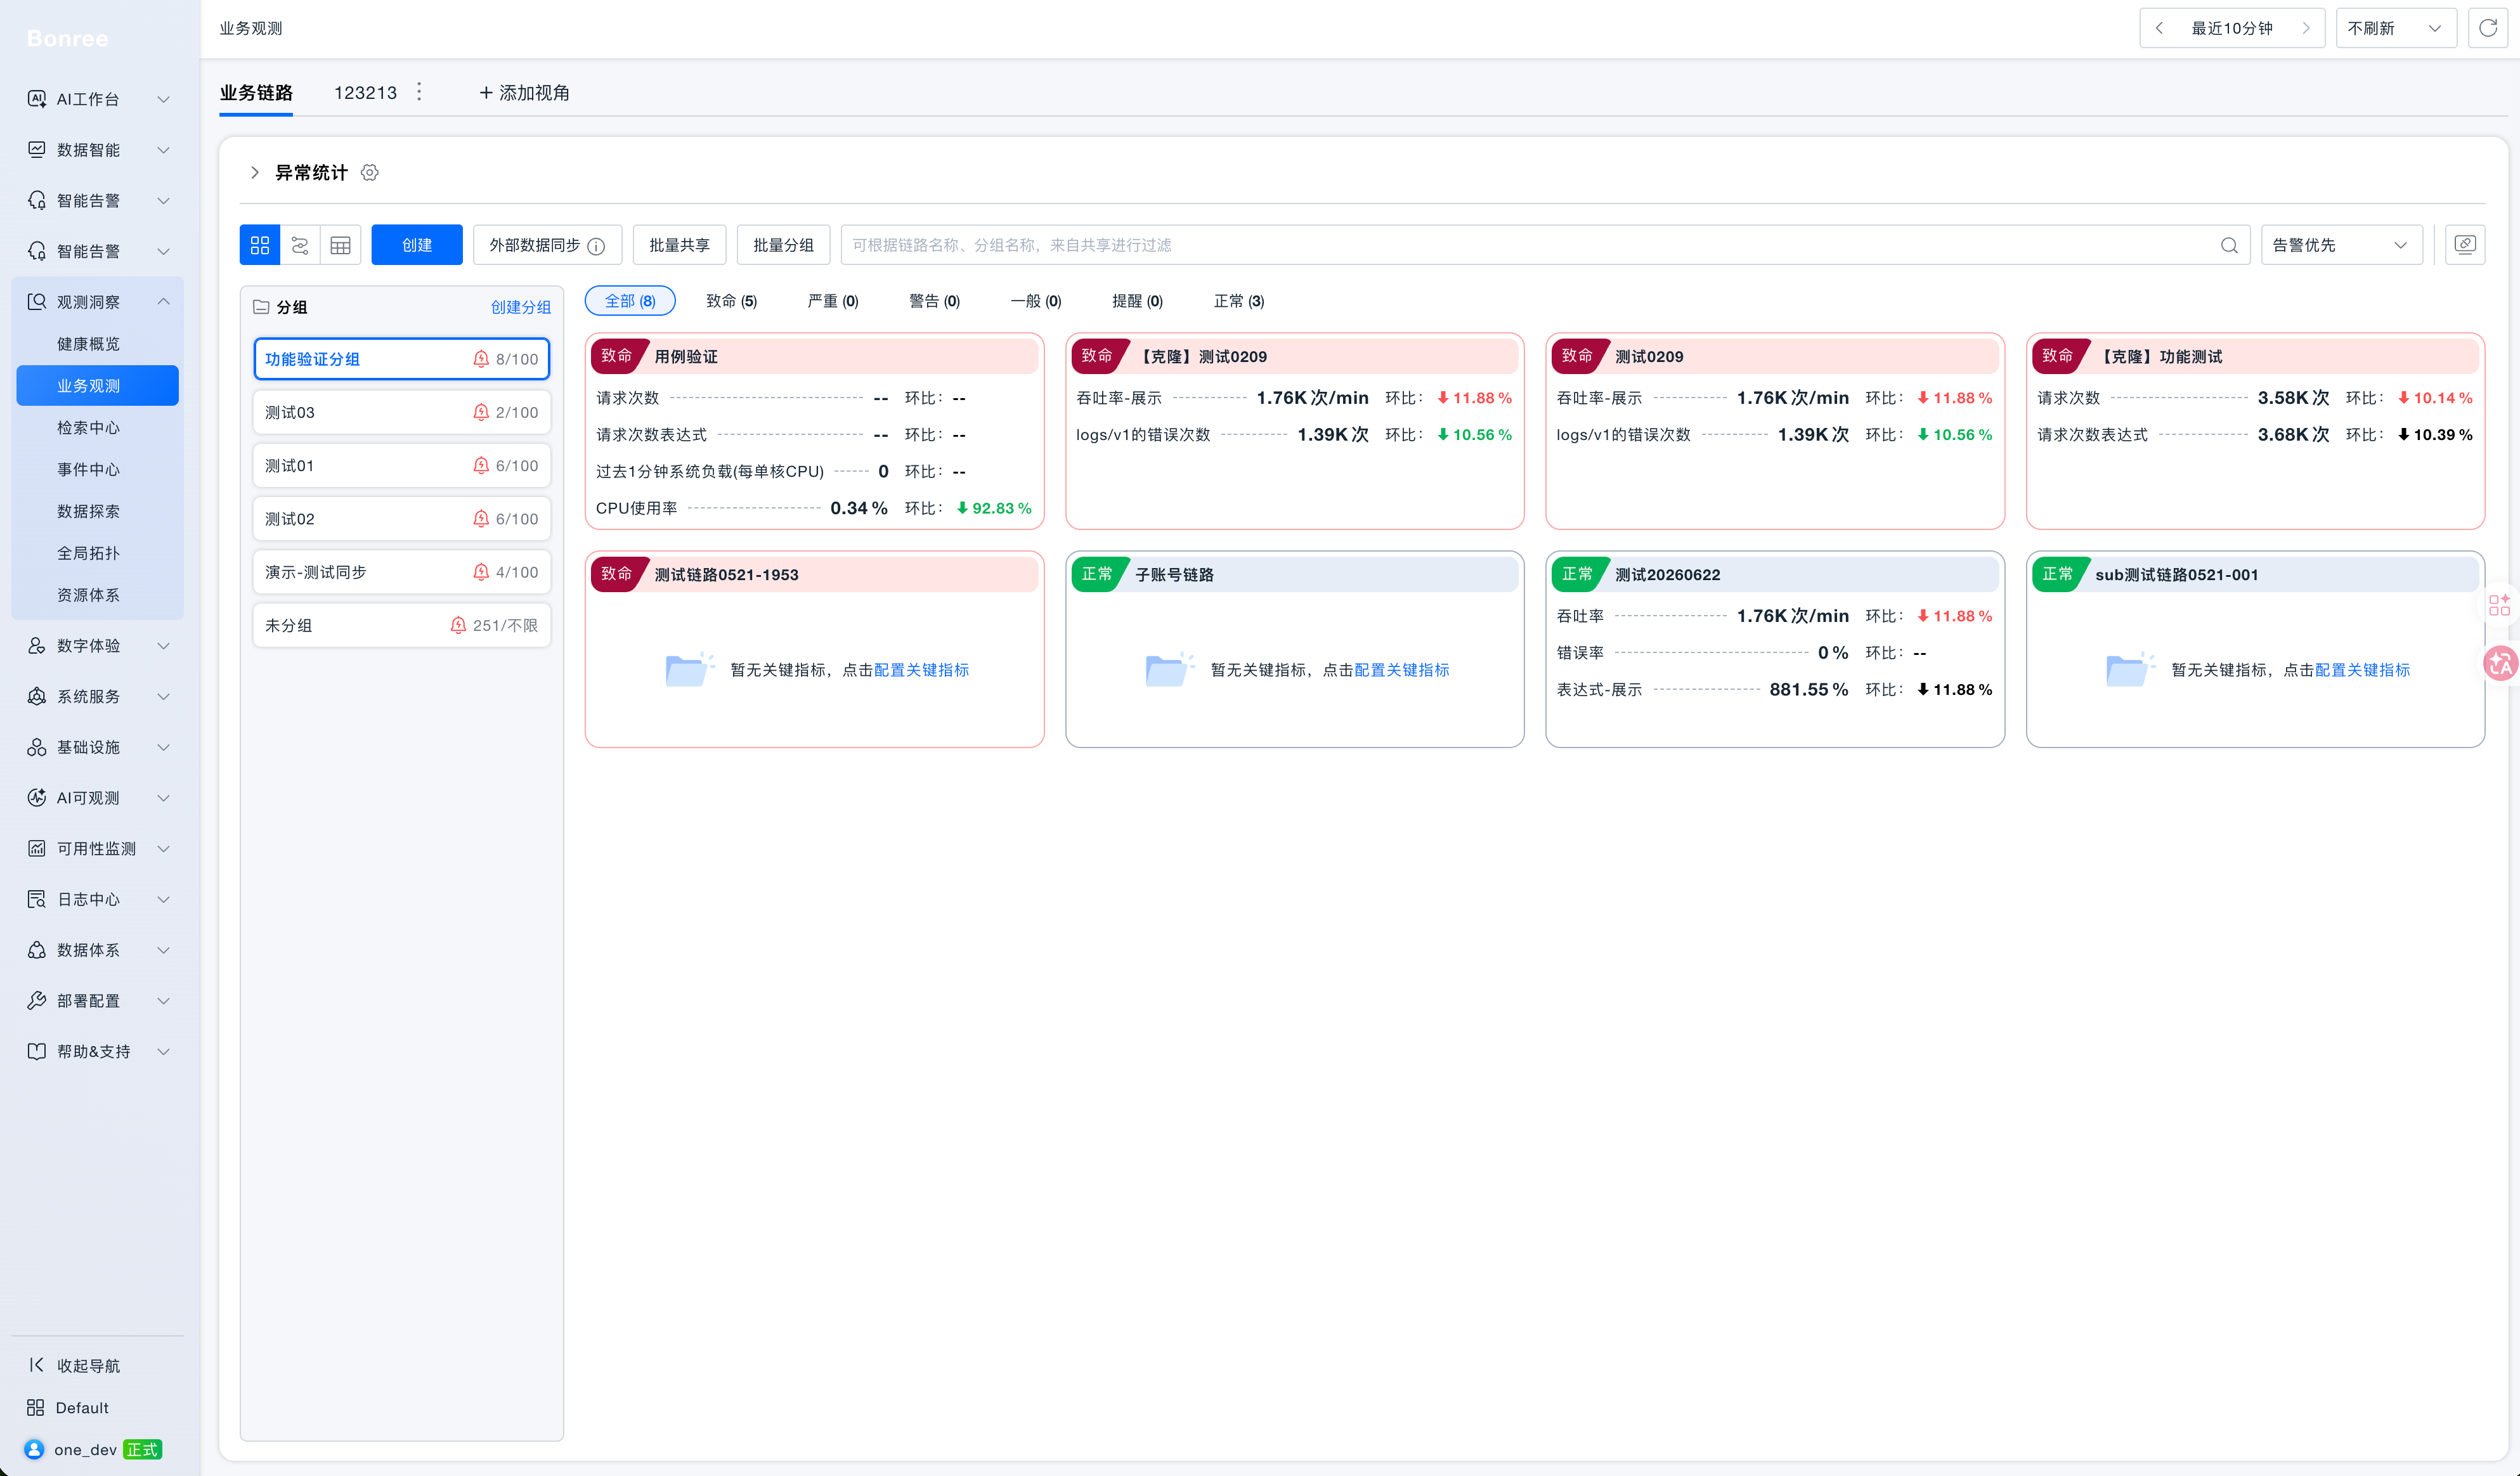
进入观测洞察 → 业务观测 → 业务链路:
- 使用状态筛选优先查看红色异常卡片或绿色正常卡片。
- 按业务链路名称、分组名称、创建人或共享来源搜索;需要只查看本人或指定人员创建的链路时,使用创建人筛选。
- 需要比较同一业务域时,切换到对应卡片分组。
查看卡片时,按以下信息判断是否需要处理:
| 卡片信息 | 判断方式 |
|---|---|
| 健康状态 | 致命、严重、警告、一般或提醒表示存在不同级别的异常;正常表示当前未检测到异常状态。 |
| 关键指标 | 关注请求量、吞吐量、错误率、CPU 等指标及其环比变化。 |
| 告警数量 | 告警增加时进入详情页,确认告警集中在哪个节点或资源。 |
| 数据缺失 | 卡片没有指标不等同于业务正常,需要检查指标配置和数据接入。 |
发现异常后,确认:
- 哪条业务链路变为红色。
- 错误率、响应时间、吞吐量或其他关键指标从何时开始变化。
- 是否有多条相关业务链路同时异常。
- 当前告警级别和数量是否持续上升。
2. 定位异常节点
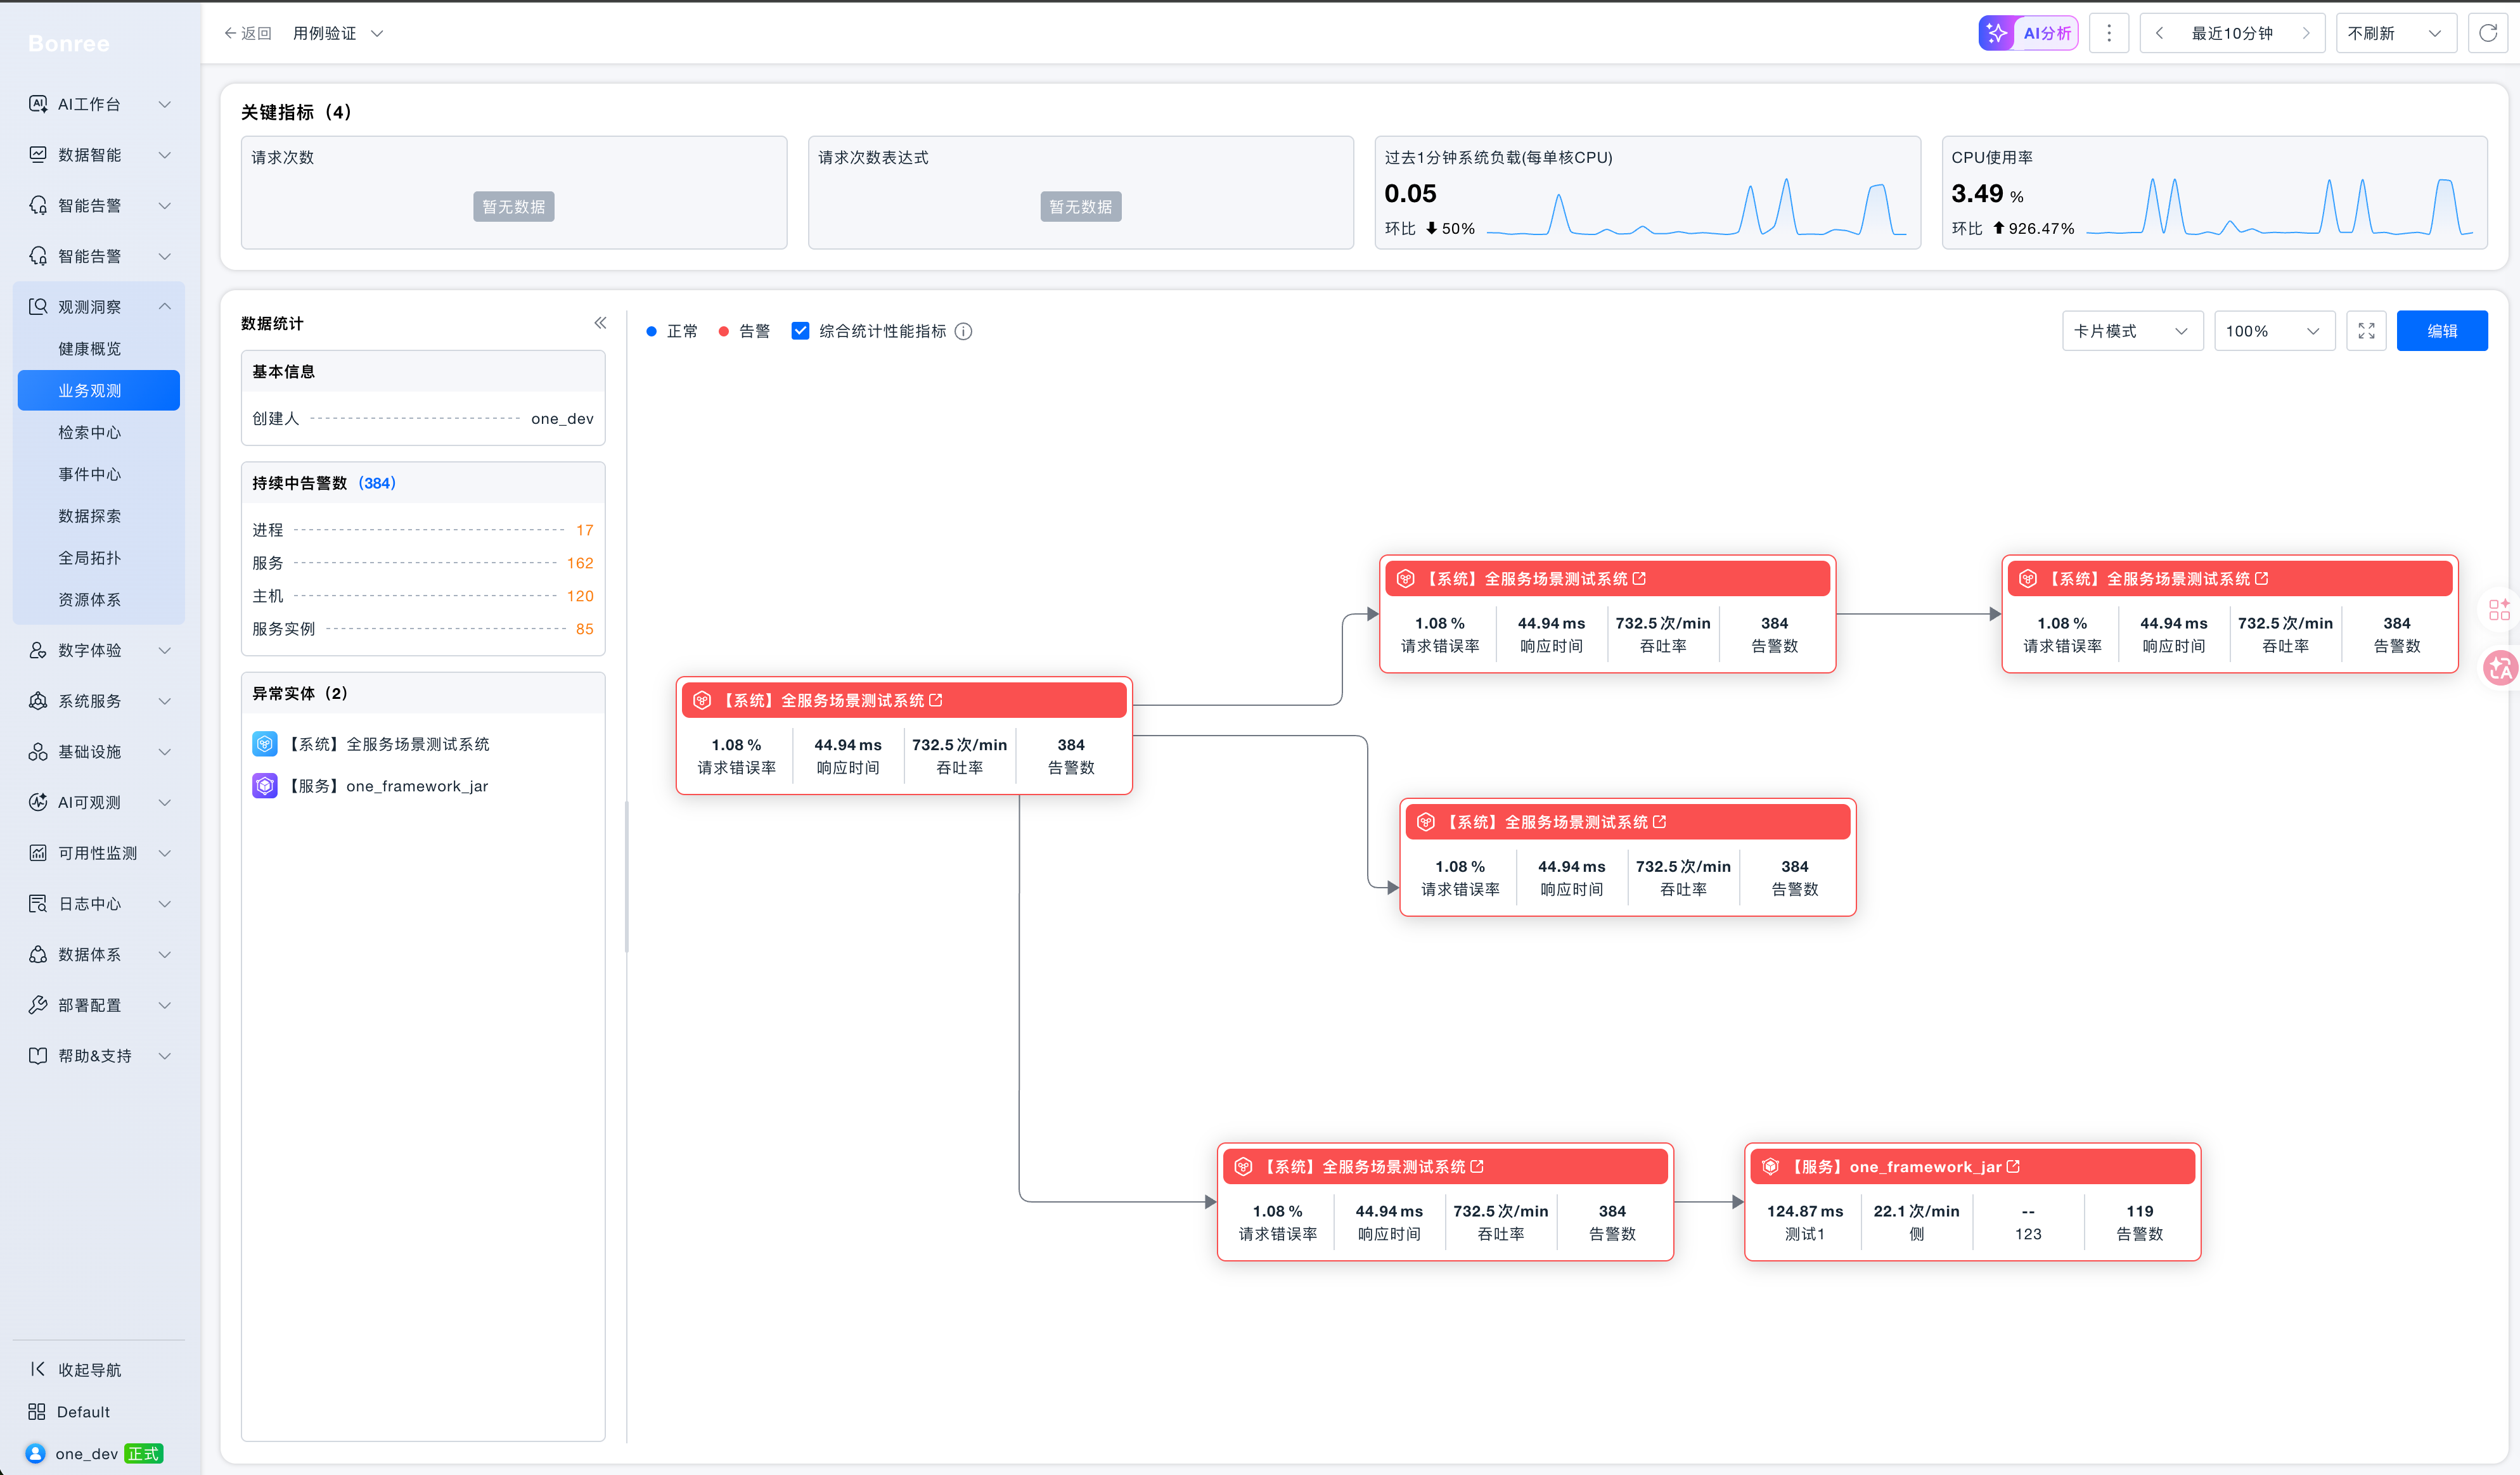
打开目标业务链路,查看链路图中的红色节点及其上下游关系。先从最接近业务入口的异常节点开始,再沿依赖方向判断异常是否向下游传播。
3. 检查节点和关联资源
点击异常节点,检查持续告警、异常实体和纵向架构。以服务节点为例,可继续确认关联主机、进程和服务实例中是否存在资源饱和、进程异常或实例故障。
4. 关联观测数据
根据异常表现选择下钻入口:
| 异常表现 | 优先查看 | 目标 |
|---|---|---|
| 响应变慢 | 指标、接口、调用链 | 找到耗时增加的接口、服务或请求。 |
| 错误率上升 | 告警、日志、调用链 | 确认错误类型、异常堆栈和失败请求。 |
| 吞吐量突变 | 指标、调用关系 | 判断流量变化及上下游影响。 |
| 资源告警 | 纵向架构、指标、日志 | 定位异常主机、进程或服务实例。 |
| 单个节点异常 | 调用关系、上下游节点 | 判断问题来自自身还是依赖传播。 |
不要只根据单一信号下结论。使用告警确定发生时间和严重程度,使用指标验证趋势,使用日志或调用链确认具体原因。
5. 验证恢复
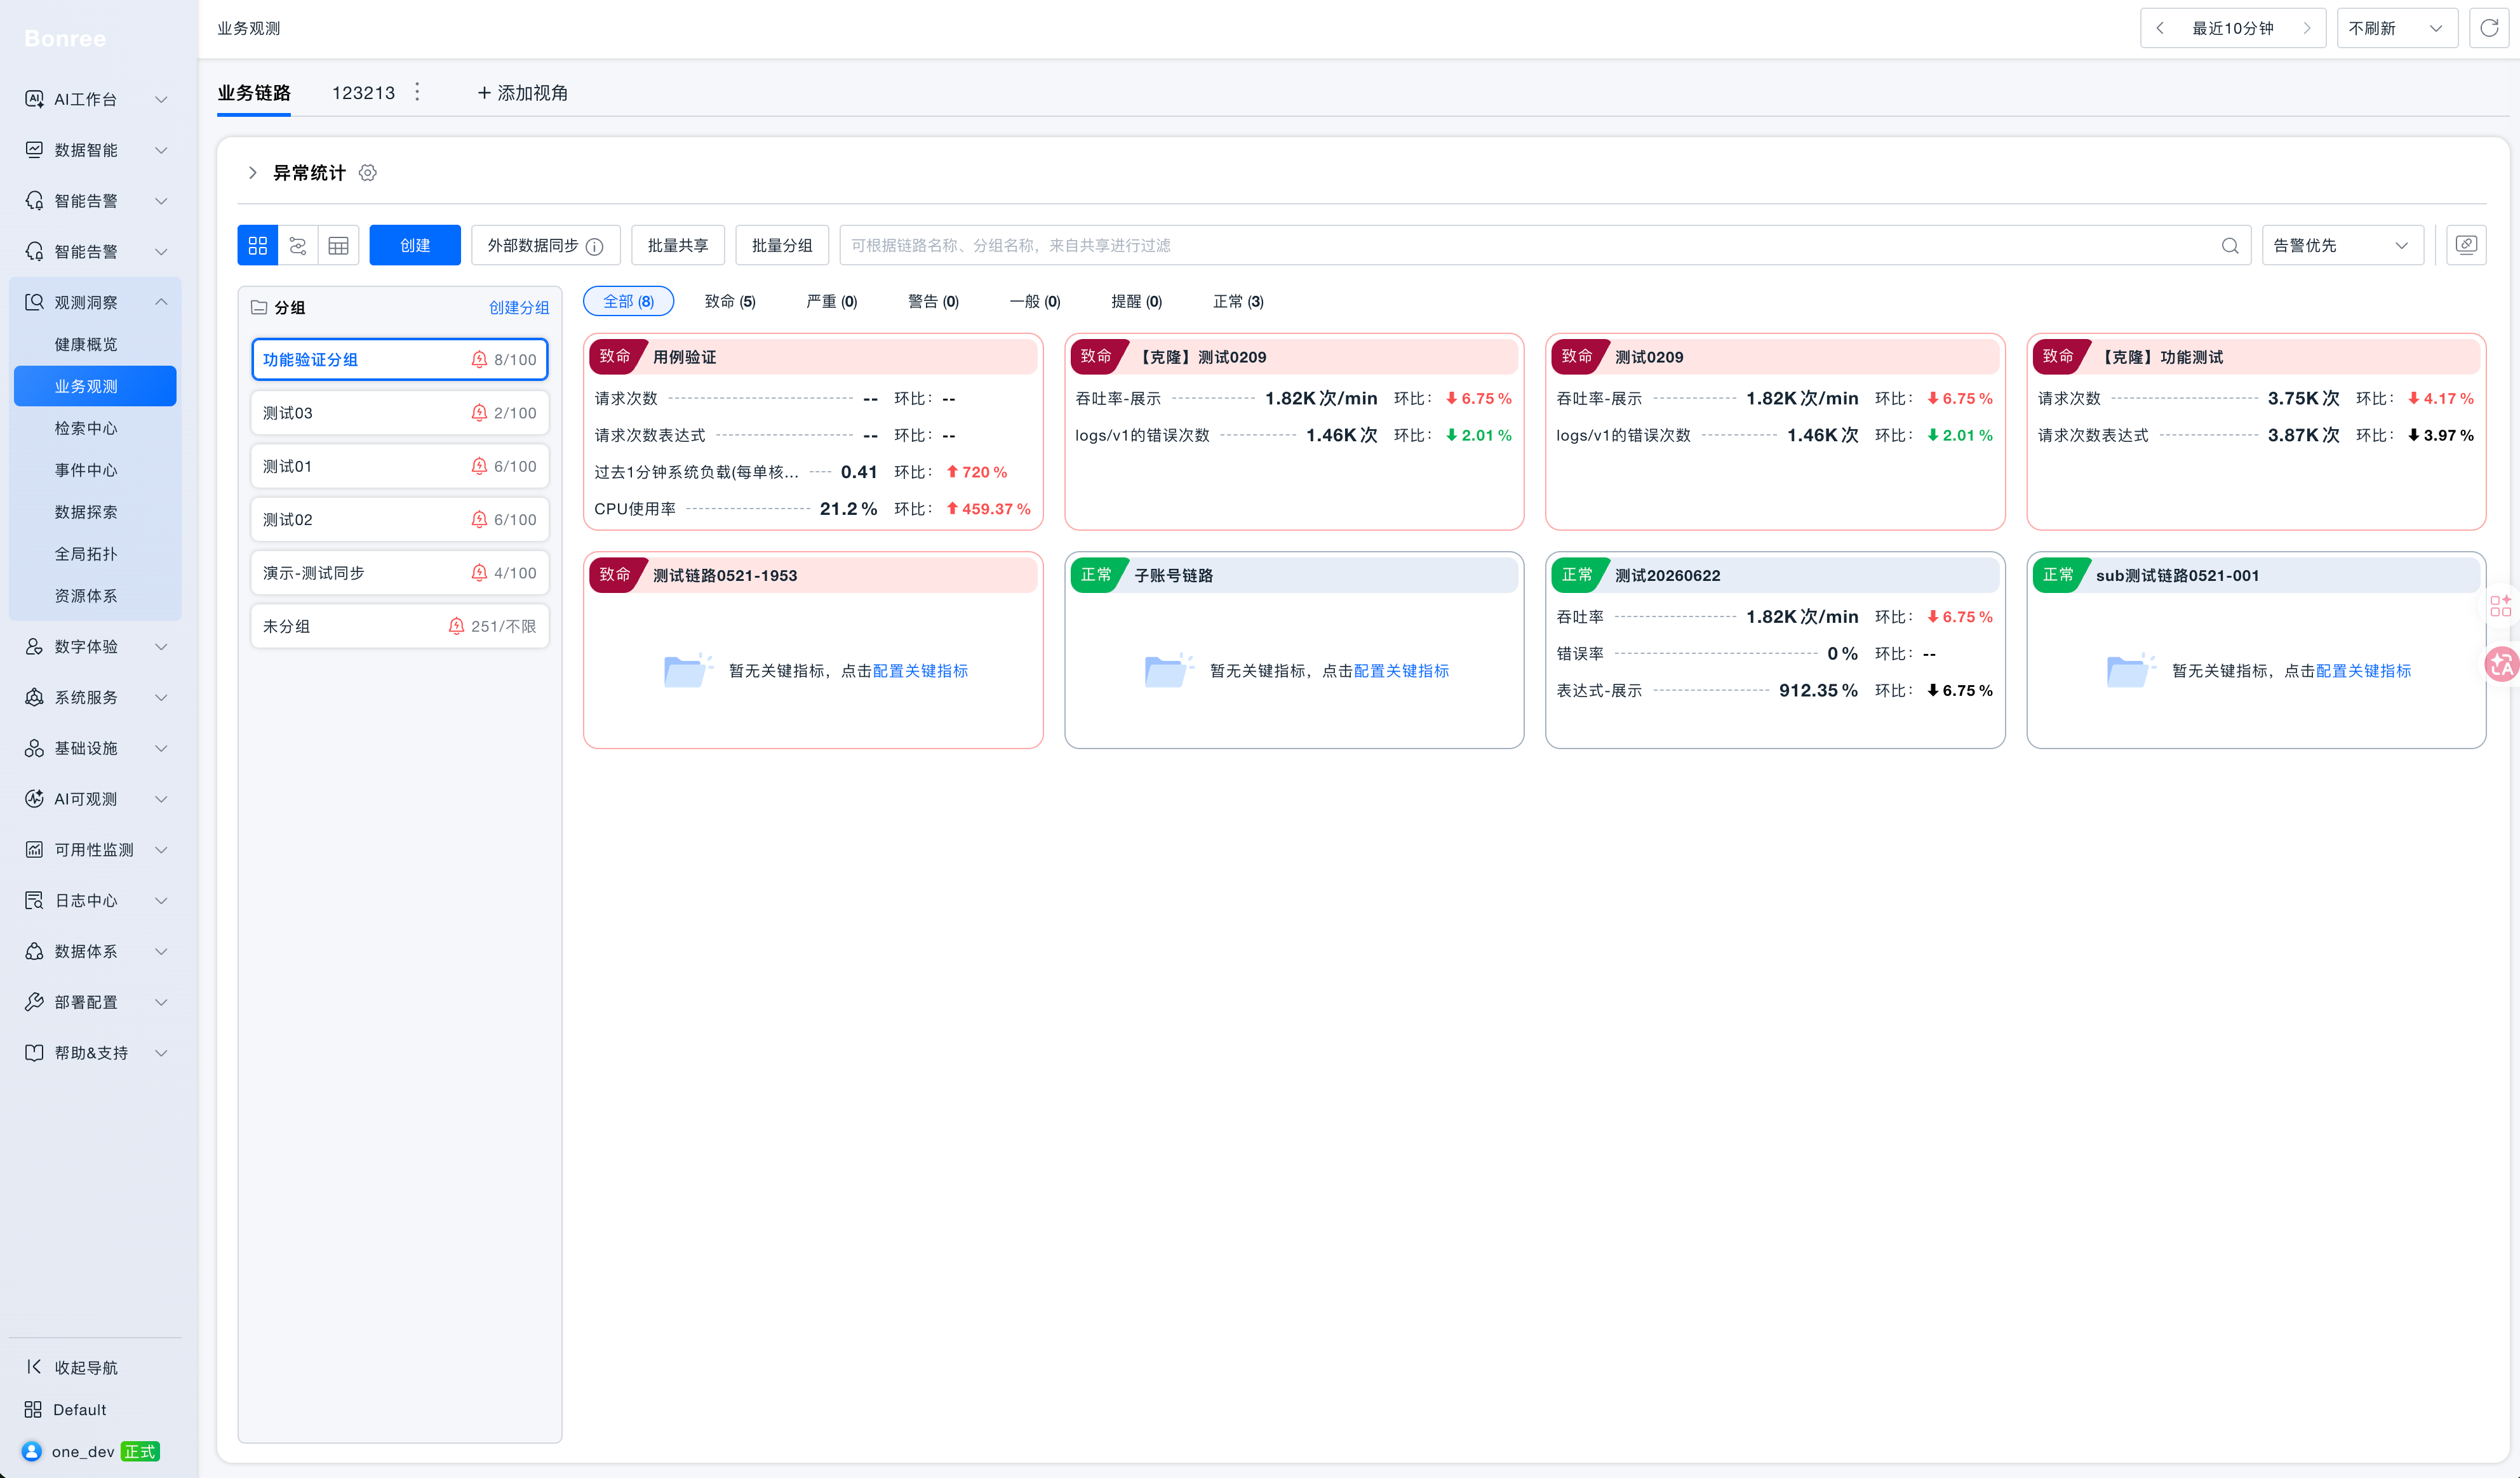
修复后继续观察同一业务链路,并确认:
- 持续告警已关闭或不再增加。
- 异常节点恢复正常状态。
- 关键指标回到预期范围或趋势。
- 上下游相关节点没有继续出现异常。
常见问题
| 现象 | 处理建议 |
|---|---|
| 只有链路级指标异常 | 检查业务链路关键指标和告警规则,再按指标关联的实体继续下钻。 |
| 节点没有日志或调用链 | 确认对应数据源已接入,且当前实体、环境和时间范围匹配。 |
| 多个节点同时变红 | 从业务入口和共同依赖开始排查,结合首次告警时间判断传播方向。 |
| 修复后仍显示异常 | 检查告警是否恢复、数据是否继续上报,并等待当前统计周期刷新。 |
| 搜索不到业务链路 | 清除状态或分组筛选,并确认链路是否由其他用户共享。 |